本帖最后由 kaaier 于 2022-5-6 22:42 编辑
您好,有在手册中看到rknn.build构建模型的配置参数,do_quantization参数表示是否进行量化, 请问默认量化为int8模型,设置为True为什么模型FP16还是FP32, 看到两个手册地方描述有歧义(RKNN_Toolkit2和RKNPU的手册),麻烦解释下!

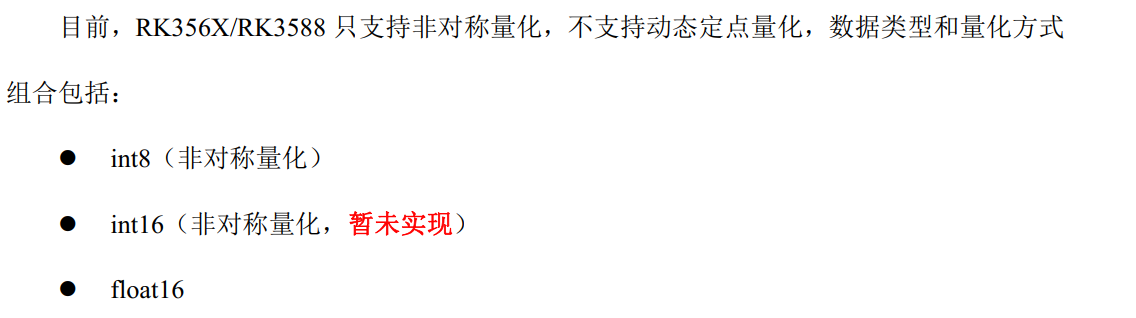
问题1. 一个支持fp16,一个说不支持,目前支持什么量化方式,是只支持int8量化,int8推理和fp16推理吗?
问题2. fp32直接转为fp16,模型为何无精度损失