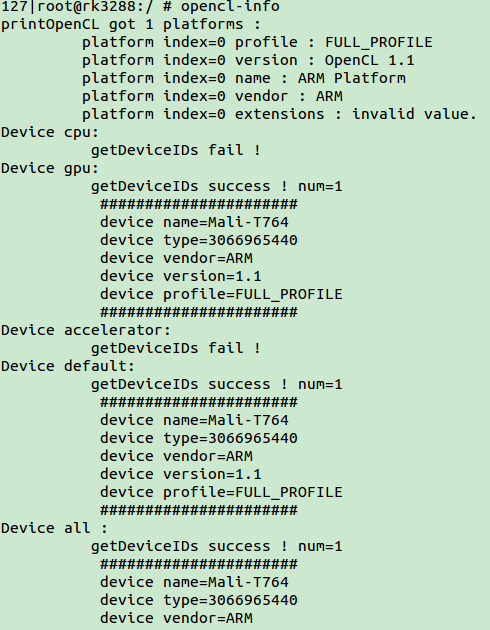
本帖最后由 bunchen 于 2015-10-28 16:23 编辑
这里贴出一个简单的向量加法的例子,和容易出错的地方。先上代码:
#include <stdio.h>
#include <stdlib.h>
#include <opencl.h>

void printDeviceWorkInfo(cl_device_id device)
{
    cl_uint nMaxComputeUnits = 0;
    cl_uint nMaxWorkItemDims = 0;
    cl_uint i = 0;
    size_t* nMaxWorkItemSizes = NULL;
    size_t nMaxWorkGroupSize = 0;
    size_t size = 0 ;
    cl_int err ;
    err = clGetDeviceInfo(device,CL_DEVICE_MAX_COMPUTE_UNITS,sizeof(cl_uint),&nMaxComputeUnits,&size);
    if(err==CL_SUCCESS){
        printf("nMaxComputeUnits=%d\n",nMaxComputeUnits);
    }

    err = clGetDeviceInfo(device,CL_DEVICE_MAX_WORK_ITEM_DIMENSIONS,sizeof(cl_uint),&nMaxWorkItemDims,&size);
    if(err==CL_SUCCESS){
        printf("nMaxWorkItemDims=%d\n",nMaxWorkItemDims);
        nMaxWorkItemSizes = (size_t*)malloc(sizeof(size_t)*nMaxWorkItemDims);
        err = clGetDeviceInfo(device,CL_DEVICE_MAX_WORK_ITEM_SIZES,sizeof(size_t)*nMaxWorkItemDims,nMaxWorkItemSizes,&size);
        if(err==CL_SUCCESS){
            for(i=0;i<nMaxWorkItemDims;i++){
                printf("nMaxWorkItemSizes[%d]=%d\n",i,nMaxWorkItemSizes[i]);
            }
        }
        free(nMaxWorkItemSizes);
    }

    err = clGetDeviceInfo(device,CL_DEVICE_MAX_WORK_GROUP_SIZE,sizeof(size_t),&nMaxWorkGroupSize,&size);
    if(err==CL_SUCCESS){
        printf("nMaxWorkGroupSize=%d\n",nMaxWorkGroupSize);
    }
}

const char* program_src = ""
"__kernel void vector_add_gpu (__global const float* src_a,\n"
"   __global const float* src_b,\n"
"   __global float* res,\n"
"   const int num)\n"
"{\n"
"   int idx = get_global_id(0);\n"
"   if(idx<num){"
"       res[idx]=src_a[idx]+src_b[idx];\n"
"   }\n"
"}\n"
;

static const cl_int vect_len = 10000000;

static float* vect_a = NULL ;
static float* vect_b = NULL ;
static float* vect_c = NULL ;

void initVects()
{
    cl_int i;
    vect_a = (float*)malloc(sizeof(float)*vect_len);
    vect_b = (float*)malloc(sizeof(float)*vect_len);
    vect_c = (float*)malloc(sizeof(float)*vect_len);
    for(i=0;i<vect_len;i++){
        vect_a[i]=(float)rand()/RAND_MAX;
        vect_b[i]=(float)rand()/RAND_MAX;
        vect_c[i]=0.0f;
    }
}

void printVects()
{
    cl_int i;
    if(vect_a && vect_b && vect_c){
        printf("######################\n");
        for(i=0;i<4;i++){
            printf("%08d : %f,%f,%f\n",i,vect_a[i],vect_b[i],vect_c[i]);
        }
        printf("    ...    \n");
        for(i=vect_len-4;i<vect_len;i++){
            printf("%08d : %f,%f,%f\n",i,vect_a[i],vect_b[i],vect_c[i]);
        }
        printf("######################\n");
    }
}

void releaseVects()
{
    if(vect_a){
        free(vect_a);
        vect_a=NULL;
    }
    if(vect_b){
        free(vect_b);
        vect_b=NULL;
    }
    if(vect_c){
        free(vect_c);
        vect_c=NULL;
    }
}

size_t shrRoundUp(size_t f , size_t s)
{
    return (s+f-1)/f*f;
}

void test()
{
    cl_int error = 0 ;
    cl_platform_id platform;
    cl_context context;
    cl_command_queue queue;
    cl_device_id device;
    cl_mem inbuf_a ;
    cl_mem inbuf_b ;
    cl_mem outbuf_r ;
    const cl_int size = vect_len;
    cl_int i ;
    const size_t mem_size = sizeof(float)*size;
    size_t program_len = strlen(program_src);
    char build_log[1024];
    size_t log_size;
    size_t local_ws;
    size_t global_ws;
    cl_kernel vector_add_kernel;

    error = clGetPlatformIDs(1,&platform,NULL);
    if(error != CL_SUCCESS){
        printf("get platform id fail !\n");
        exit(1);
    }

    error = clGetDeviceIDs(platform,CL_DEVICE_TYPE_GPU,1,&device,NULL);
    if(error != CL_SUCCESS){
        printf("get gpu device fail !\n");
        exit(1);
    }

    printDeviceWorkInfo(device);

    cl_context_properties properties[]={
        CL_CONTEXT_PLATFORM,
        (cl_context_properties)platform,
        0
    };

    // 这里要配置properties
    context = clCreateContext(properties,1,&device,NULL,NULL,&error);
    if(error != CL_SUCCESS){
        printf("create context fail !\n");
        exit(1);
    }

    queue = clCreateCommandQueue(context,device,CL_QUEUE_PROFILING_ENABLE,&error);
    if(error != CL_SUCCESS){
        printf("create command queue fail !\n");
        exit(1);
    }

    initVects();
    printVects();

    inbuf_a = clCreateBuffer(context,CL_MEM_READ_ONLY | CL_MEM_USE_HOST_PTR,mem_size,vect_a,&error);
    if(error!=CL_SUCCESS){
        printf("create buffer inbuf_a fail !\n");
        exit(1);
    }
    inbuf_b = clCreateBuffer(context,CL_MEM_READ_ONLY | CL_MEM_USE_HOST_PTR,mem_size,vect_b,&error);
    if(error!=CL_SUCCESS){
        printf("create buffer inbuf_b fail !\n");
        exit(1);
    }
    outbuf_r = clCreateBuffer(context,CL_MEM_WRITE_ONLY,mem_size,NULL,&error);
    if(error!=CL_SUCCESS){
        printf("create buffer outbuf_r fail !\n");
        exit(1);
    }

    cl_program program = clCreateProgramWithSource(context,1,&program_src,&program_len,&error);
    if(error!=CL_SUCCESS){
        printf("create program fail !\n");
        exit(1);
    }
    error = clBuildProgram(program,1,&device,NULL,NULL,NULL);
    if(error!=CL_SUCCESS){
        printf("build program fail !\n");
        clGetProgramBuildInfo(program,device,CL_PROGRAM_BUILD_LOG,1024,build_log,&log_size);
        printf("build_log : %s\n",build_log);
        exit(1);
    }

    vector_add_kernel = clCreateKernel(program,"vector_add_gpu",&error);
    if(error!=CL_SUCCESS){
        printf("create kernel fail !\n");
        exit(1);
    }

    error = clSetKernelArg(vector_add_kernel,0,sizeof(cl_mem),&inbuf_a);
    error |= clSetKernelArg(vector_add_kernel,1,sizeof(cl_mem),&inbuf_b);
    error |= clSetKernelArg(vector_add_kernel,2,sizeof(cl_mem),&outbuf_r);
    error |= clSetKernelArg(vector_add_kernel,3,sizeof(cl_int),&size);
    if(error!=CL_SUCCESS){
        printf("set kernel arg fail !\n");
        exit(1);
    }

    local_ws = 256;  //我们使用一维的clEnqueueNDRangeKernel,这里local_ws选择nMaxWorkItemSizes[0]=256
    global_ws = shrRoundUp(local_ws,size); //这里是线程总数,应该是local_ws的倍数。
    printf("local_ws=%d,global_ws=%d\n",local_ws,global_ws);

    error = clEnqueueNDRangeKernel(queue,vector_add_kernel,1,NULL,&global_ws,&local_ws,0,NULL,NULL);
    if(error!=CL_SUCCESS){
        printf("enqueue kernel fail !\n");
        exit(1);
    }

    clEnqueueReadBuffer(queue,outbuf_r,CL_TRUE,0,mem_size,vect_c,0,NULL,NULL);
    printVects();

    clReleaseKernel(vector_add_kernel);
    clReleaseProgram(program);
    clReleaseCommandQueue(queue);
    clReleaseContext(context);
    clReleaseMemObject(inbuf_a);
    clReleaseMemObject(inbuf_b);
    clReleaseMemObject(outbuf_r);
    releaseVects();
}

int main(){
        test();
        return 0;
}
这里说一下容易出错的地方:
(1)clCreateContext,网上有些例子把第一个参数置成0,经试验这样不行,要设置properties。
(2)clEnqueueNDRangeKernel的global_work_size和local_work_size。我们使用一维的clEnqueueNDRangeKernel,这里local_work_size选择nMaxWorkItemSizes[0]=256,global_work_size是线程总数,应该是local_ws的倍数。
一维情况下:
二维情况下:
(3)kernel代码中
size_t get_global_id (uint dimindx)
返回这个线程的global_id,参数是维度索引,我们一维的情况下参数是0。
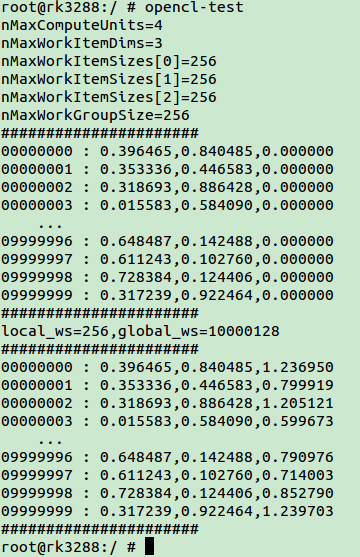
最后运行结果:
在加一个nv12转rgb的例子:
#include <stdio.h>
#include <stdlib.h>
#include <opencl.h>
#include <sys/time.h>

void printDeviceWorkInfo(cl_device_id device)
{
    cl_uint nMaxComputeUnits = 0;
    cl_uint nMaxWorkItemDims = 0;
    cl_uint i = 0;
    size_t* nMaxWorkItemSizes = NULL;
    size_t nMaxWorkGroupSize = 0;
    size_t size = 0 ;
    cl_int err ;
    err = clGetDeviceInfo(device,CL_DEVICE_MAX_COMPUTE_UNITS,sizeof(cl_uint),&nMaxComputeUnits,&size);
    if(err==CL_SUCCESS){
        printf("nMaxComputeUnits=%d\n",nMaxComputeUnits);
    }

    err = clGetDeviceInfo(device,CL_DEVICE_MAX_WORK_ITEM_DIMENSIONS,sizeof(cl_uint),&nMaxWorkItemDims,&size);
    if(err==CL_SUCCESS){
        printf("nMaxWorkItemDims=%d\n",nMaxWorkItemDims);
        nMaxWorkItemSizes = (size_t*)malloc(sizeof(size_t)*nMaxWorkItemDims);
        err = clGetDeviceInfo(device,CL_DEVICE_MAX_WORK_ITEM_SIZES,sizeof(size_t)*nMaxWorkItemDims,nMaxWorkItemSizes,&size);
        if(err==CL_SUCCESS){
            for(i=0;i<nMaxWorkItemDims;i++){
                printf("nMaxWorkItemSizes[%d]=%d\n",i,nMaxWorkItemSizes[i]);
            }
        }
        free(nMaxWorkItemSizes);
    }

    err = clGetDeviceInfo(device,CL_DEVICE_MAX_WORK_GROUP_SIZE,sizeof(size_t),&nMaxWorkGroupSize,&size);
    if(err==CL_SUCCESS){
        printf("nMaxWorkGroupSize=%d\n",nMaxWorkGroupSize);
    }
}

const char* program_src = ""
"__kernel void nv12_to_rgb (__global const unsigned char* nv12,\n"
"   __global unsigned char* rgb,\n"
"   const int width,\n"
"   const int height)\n"
"{\n"
"   int idi = get_global_id(0);\n"
"   int idj = get_global_id(1);\n"
"   int k = 0 ;\n"
"   int y = 0 ;\n"
"   int u = 0 ;\n"
"   int v = 0 ;\n"
"   int t = 0 ;\n"
"   if(idi<width && idj<height){\n"
"       y=nv12[idj*width+idi];\n"
"       k=width*height+((idj/2)*(width/2)+idi/2)*2;\n"
"       u=nv12[k];\n"
"       v=nv12[k+1];\n"
"       k=(idj*width+idi)*3;\n"
"       t=(int)(y+1.370705*v-175.4502);\n"
"       rgb[k]=t>255?255:t<0?0:t;\n"
"       t=(int)(y-0.698001*v-0.337633*u+132.56124);\n"
"       rgb[k+1]=t>255?255:t<0?0:t;\n"
"       t=(int)(y+1.732446*u-221.7531);"
"       rgb[k+2]=t>255?255:t<0?0:t;\n"
"   }\n"
"}\n"
;

size_t shrRoundUp(size_t f , size_t s)
{
    return (s+f-1)/f*f;
}

void nv12_to_rgb(uint8_t* rgb , uint8_t* nv12 , int width , int height)
{
    cl_int error = 0 ;
    cl_platform_id platform;
    cl_context context;
    cl_command_queue queue;
    cl_device_id device;
    cl_mem inbuf_nv12 ;
    cl_mem outbuf_rgb ;
    cl_int i ;
    size_t program_len = strlen(program_src);
    char build_log[1024];
    size_t log_size;
    size_t local_ws;
    size_t global_ws;
    cl_kernel nv12_to_rgb;

    cl_int nv12_size = width*height*3/2;
    cl_int rgb_size = width*height*3;

    error = clGetPlatformIDs(1,&platform,NULL);
    if(error != CL_SUCCESS){
        printf("get platform id fail !\n");
        exit(1);
    }

    error = clGetDeviceIDs(platform,CL_DEVICE_TYPE_GPU,1,&device,NULL);
    if(error != CL_SUCCESS){
        printf("get gpu device fail !\n");
        exit(1);
    }

    printDeviceWorkInfo(device);

    cl_context_properties properties[]={
        CL_CONTEXT_PLATFORM,
        (cl_context_properties)platform,
        0
    };

    // 这里要配置properties
    context = clCreateContext(properties,1,&device,NULL,NULL,&error);
    if(error != CL_SUCCESS){
        printf("create context fail !\n");
        exit(1);
    }

    queue = clCreateCommandQueue(context,device,CL_QUEUE_PROFILING_ENABLE,&error);
    if(error != CL_SUCCESS){
        printf("create command queue fail !\n");
        exit(1);
    }

    cl_program program = clCreateProgramWithSource(context,1,&program_src,&program_len,&error);
    if(error!=CL_SUCCESS){
        printf("create program fail !\n");
        exit(1);
    }
    error = clBuildProgram(program,1,&device,NULL,NULL,NULL);
    if(error!=CL_SUCCESS){
        printf("build program fail !\n");
        clGetProgramBuildInfo(program,device,CL_PROGRAM_BUILD_LOG,1024,build_log,&log_size);
        printf("build_log : %s\n",build_log);
        exit(1);
    }

    nv12_to_rgb = clCreateKernel(program,"nv12_to_rgb",&error);
    if(error!=CL_SUCCESS){
        printf("create kernel fail !\n");
        exit(1);
    }

    struct timeval val;
    gettimeofday(&val,NULL);
    long t1 = val.tv_sec*1000000 + val.tv_usec;

    inbuf_nv12 = clCreateBuffer(context,CL_MEM_READ_ONLY | CL_MEM_USE_HOST_PTR,nv12_size,nv12,&error);
    if(error!=CL_SUCCESS){
        printf("create buffer inbuf_a fail !\n");
        exit(1);
    }
    outbuf_rgb = clCreateBuffer(context,CL_MEM_WRITE_ONLY,rgb_size,NULL,&error);
    if(error!=CL_SUCCESS){
        printf("create buffer outbuf_r fail !\n");
        exit(1);
    }

    error = clSetKernelArg(nv12_to_rgb,0,sizeof(cl_mem),&inbuf_nv12);
    error |= clSetKernelArg(nv12_to_rgb,1,sizeof(cl_mem),&outbuf_rgb);
    error |= clSetKernelArg(nv12_to_rgb,2,sizeof(cl_int),&width);
    error |= clSetKernelArg(nv12_to_rgb,3,sizeof(cl_int),&height);

    if(error!=CL_SUCCESS){
        printf("set kernel arg fail !\n");
        exit(1);
    }

    size_t lws[2] = {16,16};
    size_t gws[2];
    gws[0] = shrRoundUp(lws[0],width);
    gws[1] = shrRoundUp(lws[1],height);
    printf("lws={%d,%d},gws={%d,%d}\n",lws[0],lws[1],gws[0],gws[1]);

    error = clEnqueueNDRangeKernel(queue,nv12_to_rgb,2,NULL,gws,lws,0,NULL,NULL);
    if(error!=CL_SUCCESS){
        printf("enqueue kernel fail !\n");
        exit(1);
    }

    clEnqueueReadBuffer(queue,outbuf_rgb,CL_TRUE,0,rgb_size,rgb,0,NULL,NULL);

    clReleaseMemObject(inbuf_nv12);
    clReleaseMemObject(outbuf_rgb);

    gettimeofday(&val,NULL);
    long t2 = val.tv_sec*1000000 + val.tv_usec;

    printf("nv12_to_rgb spend %ld (us)\n",t2-t1);

    clReleaseKernel(nv12_to_rgb);
    clReleaseProgram(program);
    clReleaseCommandQueue(queue);
    clReleaseContext(context);
}

int main(){
    uint8_t* nv12;
    uint8_t* rgb;
    int width=1920;
    int height=1080;
    int i,j,k;
    nv12=(uint8_t*)malloc(width*height*3/2);
    rgb=(uint8_t*)malloc(width*height*3);

    memset(nv12,0,width*height*3/2);

    memset(rgb,0,width*height*3);
    struct timeval val;
    gettimeofday(&val,NULL);
    long t1 = val.tv_sec*1000000 + val.tv_usec;
        nv12_to_rgb(rgb,nv12,width,height);
    gettimeofday(&val,NULL);
    long t2 = val.tv_sec*1000000 + val.tv_usec;
    printf("nv12_to_rgb spend %ld (us)\n",t2-t1);
        for(j=0;j<8;j++){
            for(i=0;i<8;i++){
                k=(j*width+i)*3;
                printf("(%02x,%02x,%02x) ",rgb[k],rgb[k+1],rgb[k+2]);
            }
            printf("\n");
            }
        printf("......\n");
        for(j=height-8;j<height;j++){
            for(i=width-8;i<width;i++){
                k=(j*width+i)*3;
                printf("(%02x,%02x,%02x) ",rgb[k],rgb[k+1],rgb[k+2]);
            }
            printf("\n");
            }

        free(nv12);
        free(rgb);
        return 0;
}
这是一个二维的例子,local_work_item[0]*local_work_item[1]要小于最大的workitem数,即 local_work_item[0]*local_work_item[1]<256,所以取
local_work_item[0]=local_work_item[1]=16